Seminars & paper readings › Paper reading
Improving Language Models by Retrieving from Trillions of Tokens (RETRO)
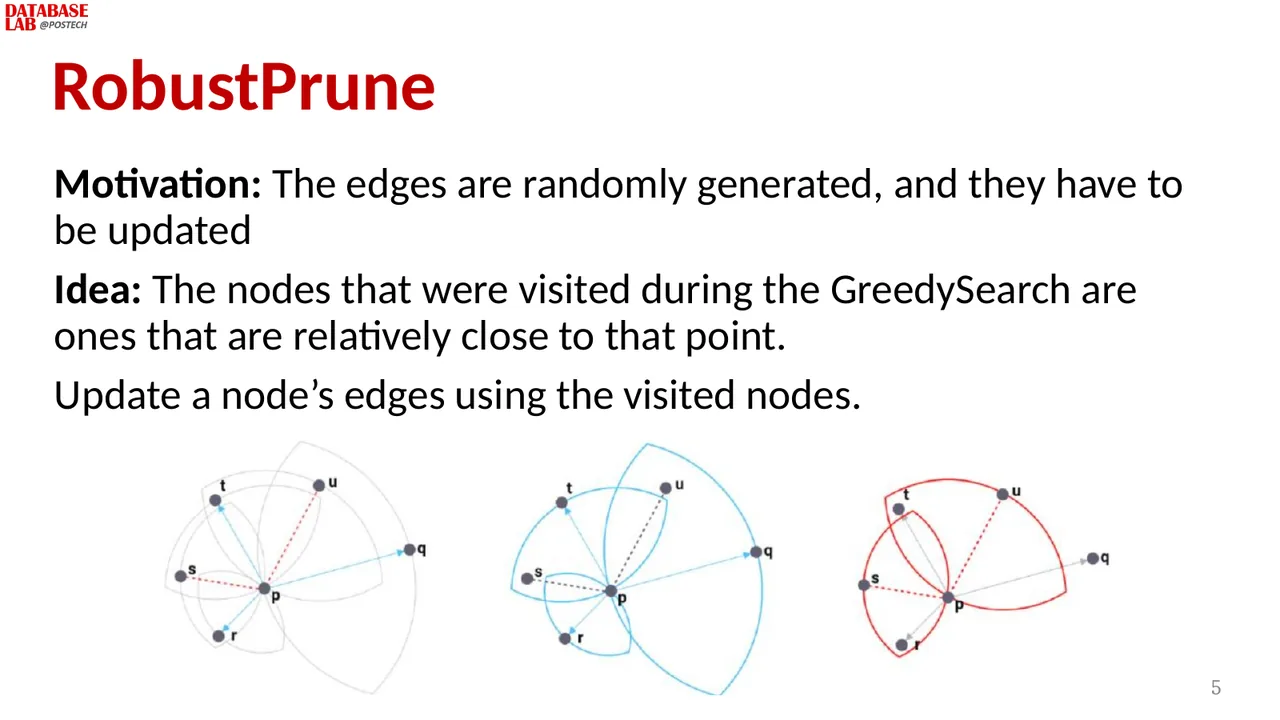
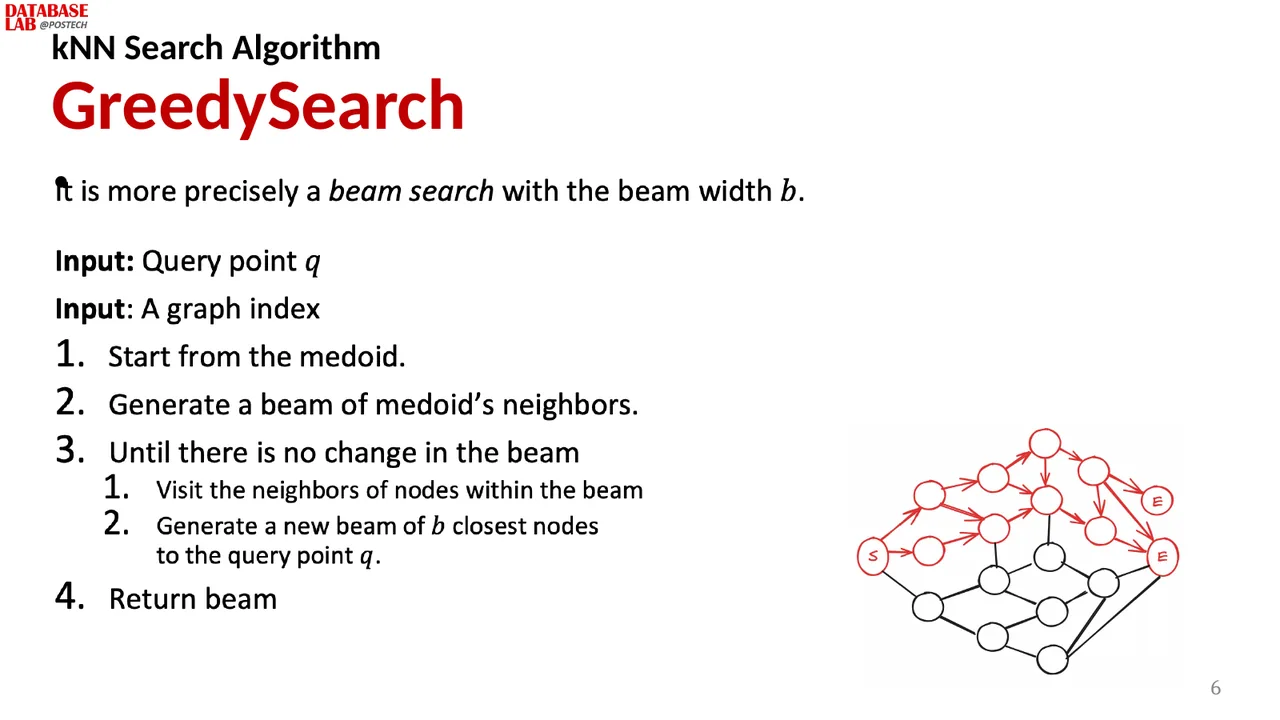
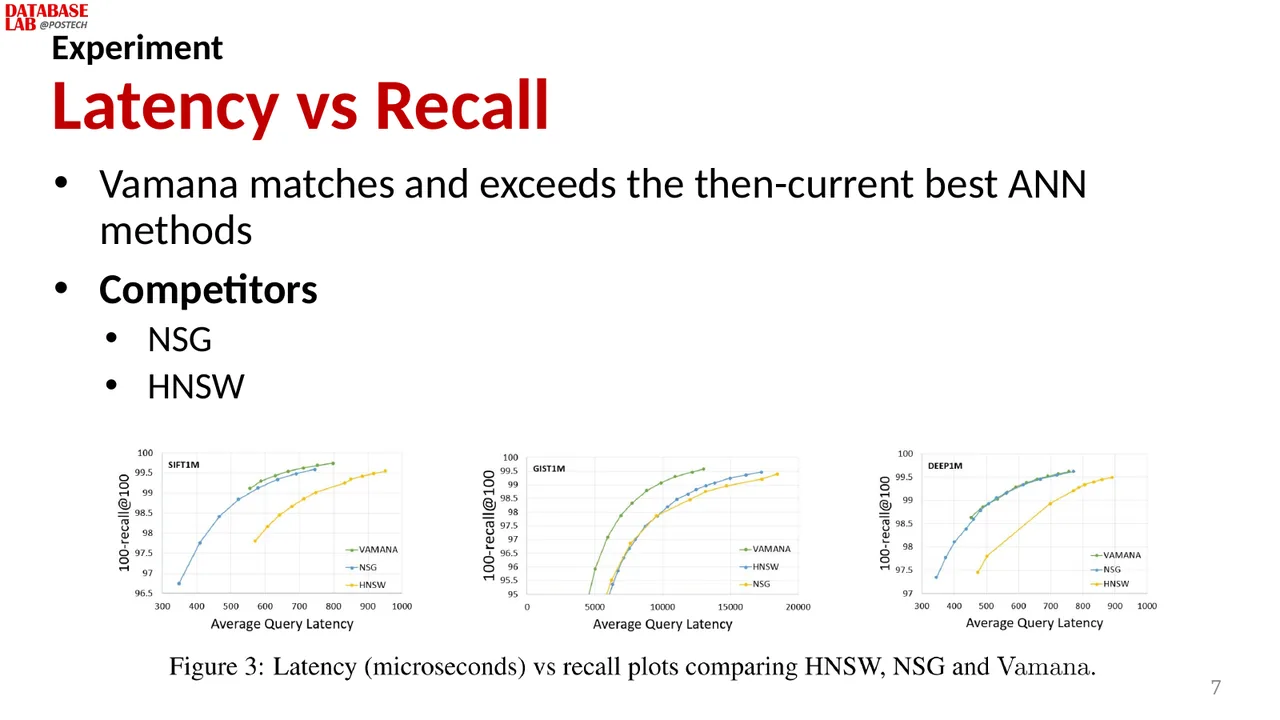
Borgeaud et al., ICML 2022 · presented by Joohyung Yun · opens with DiskANN (Subramanya et al., NeurIPS 2019)
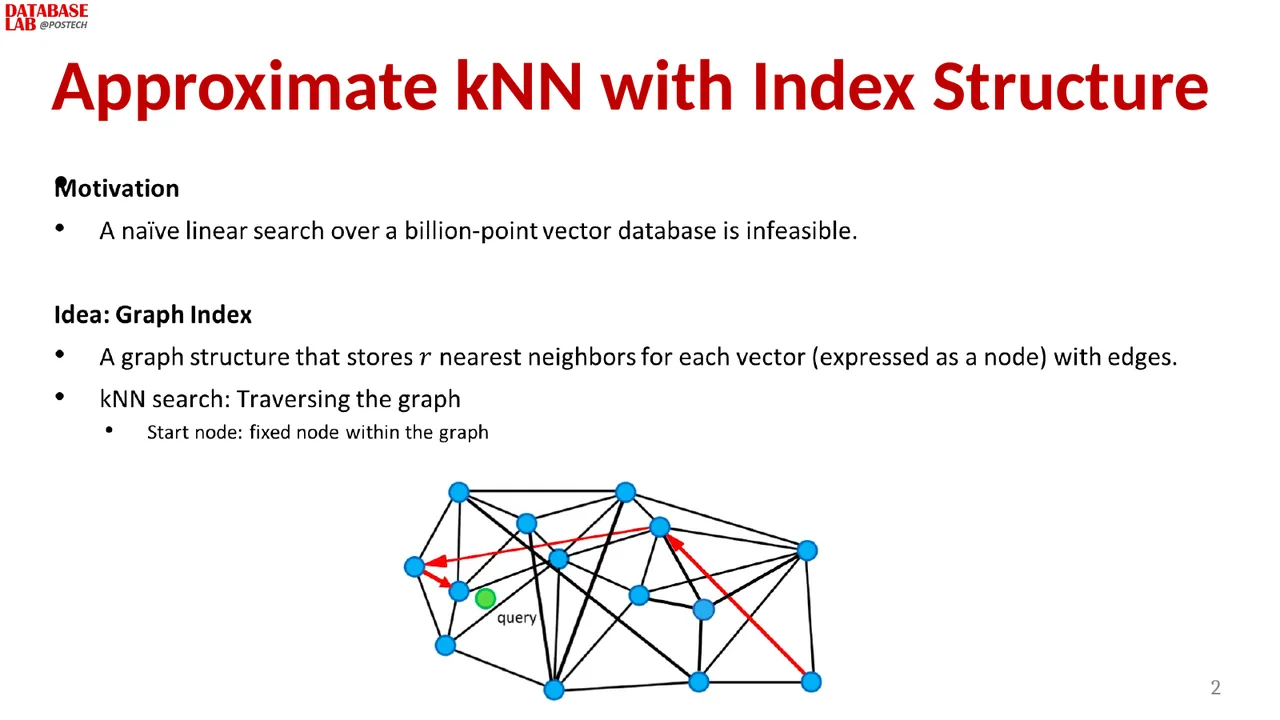
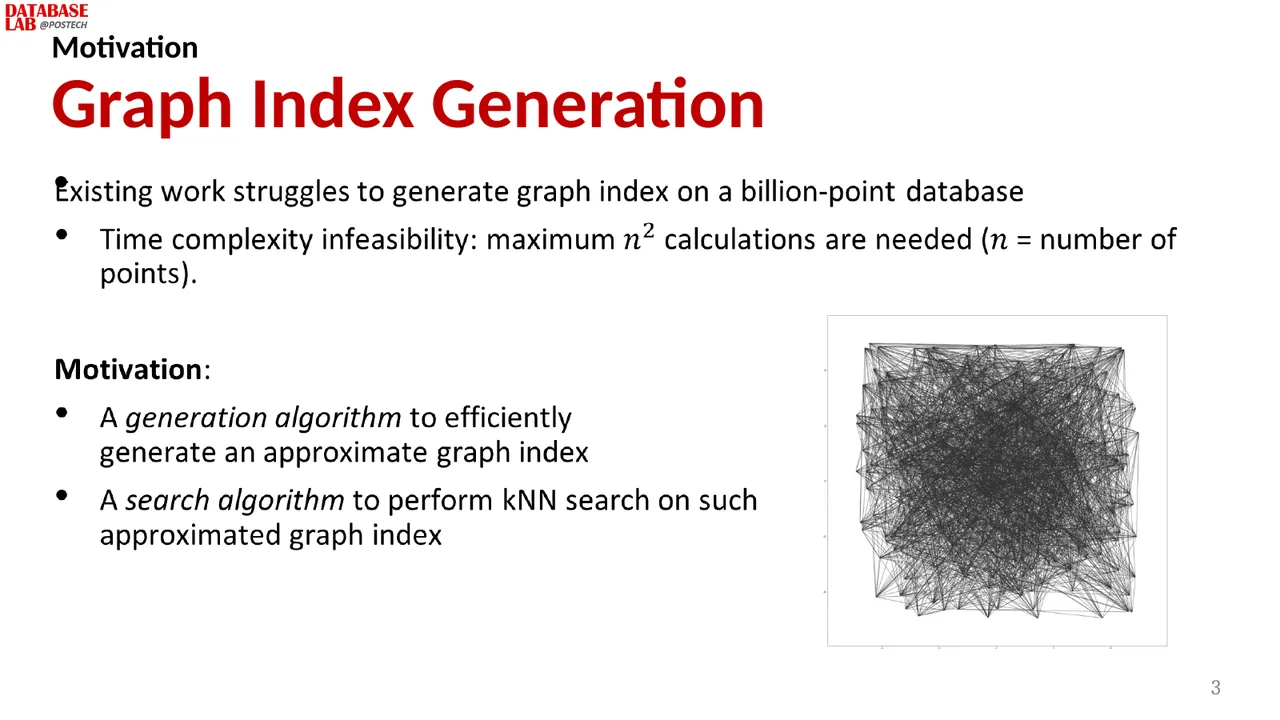
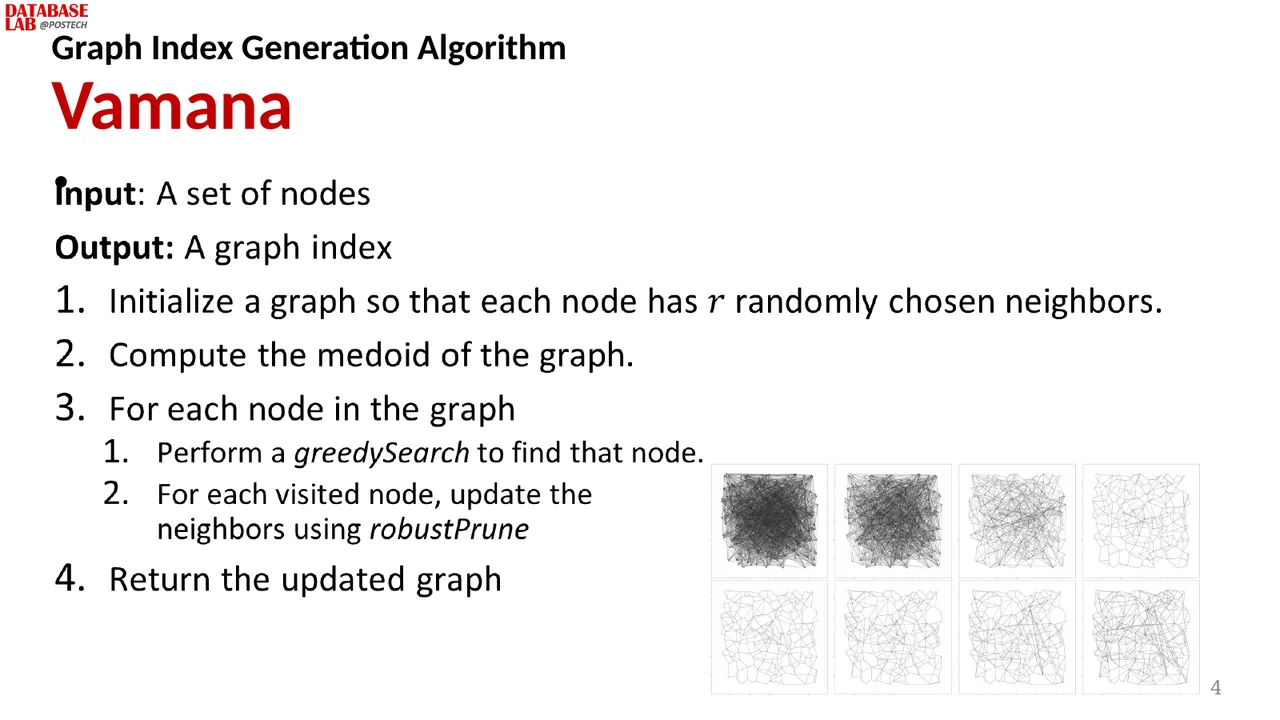
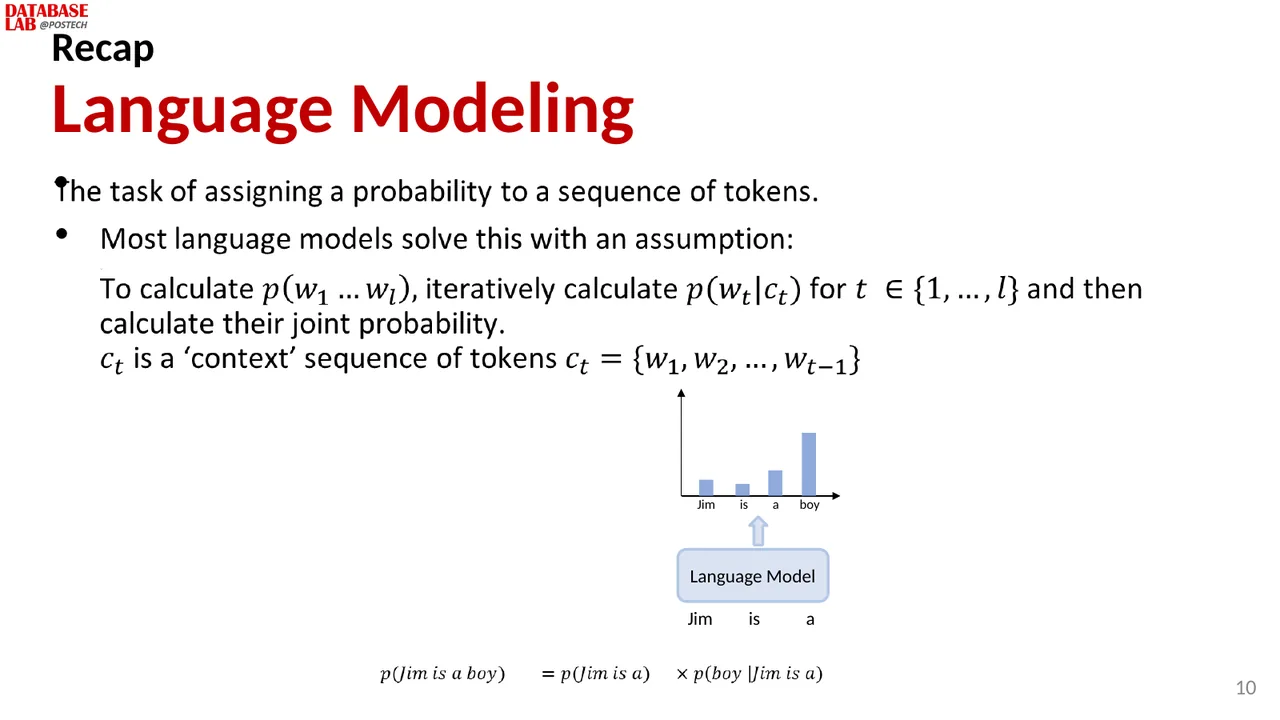
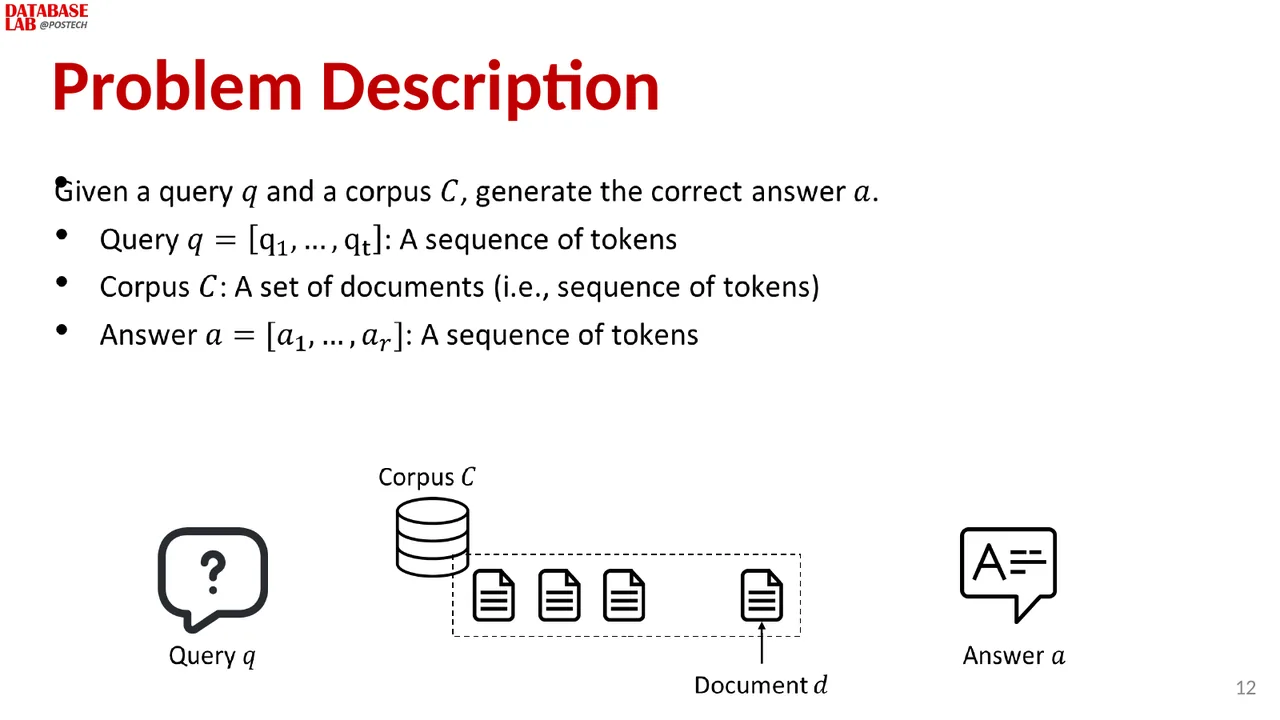
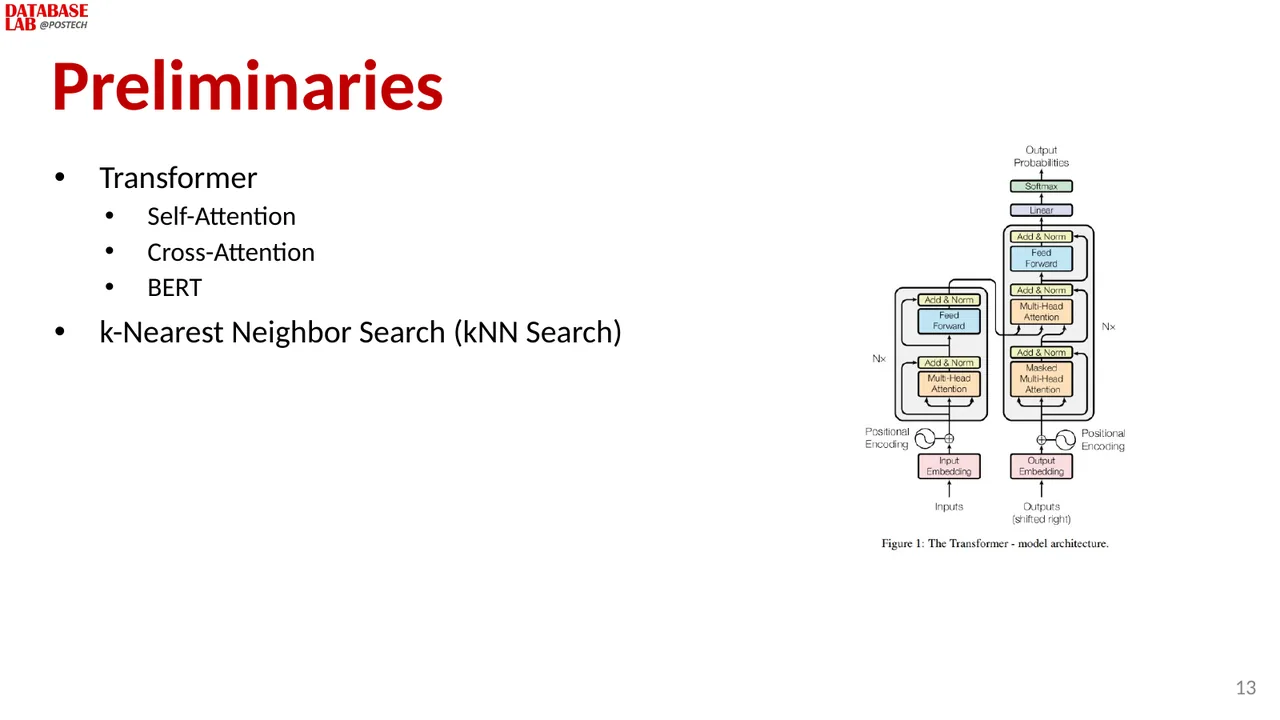
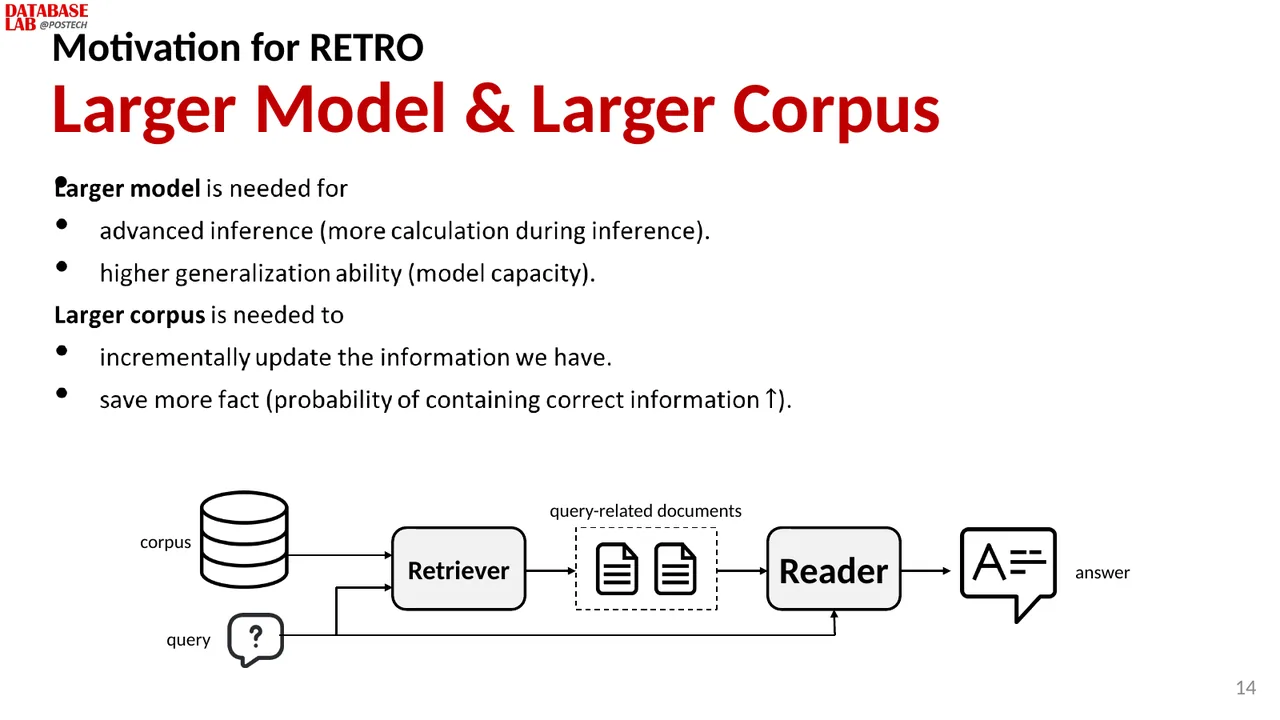
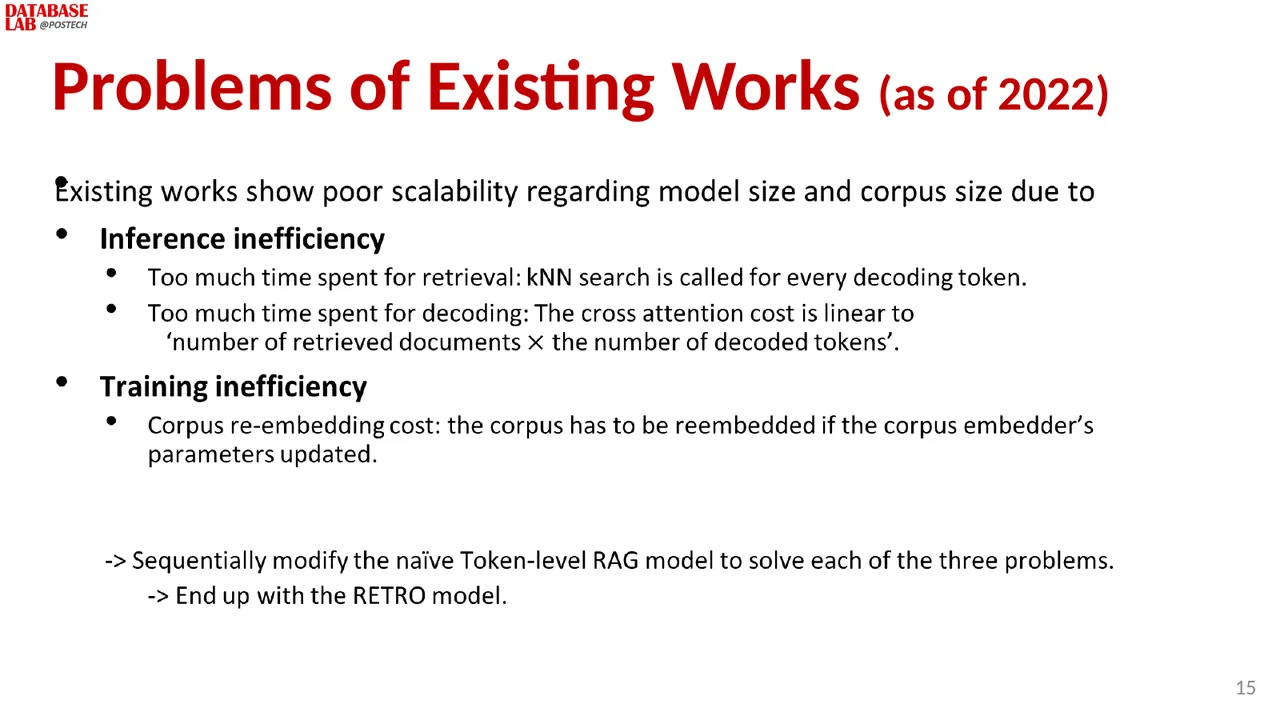
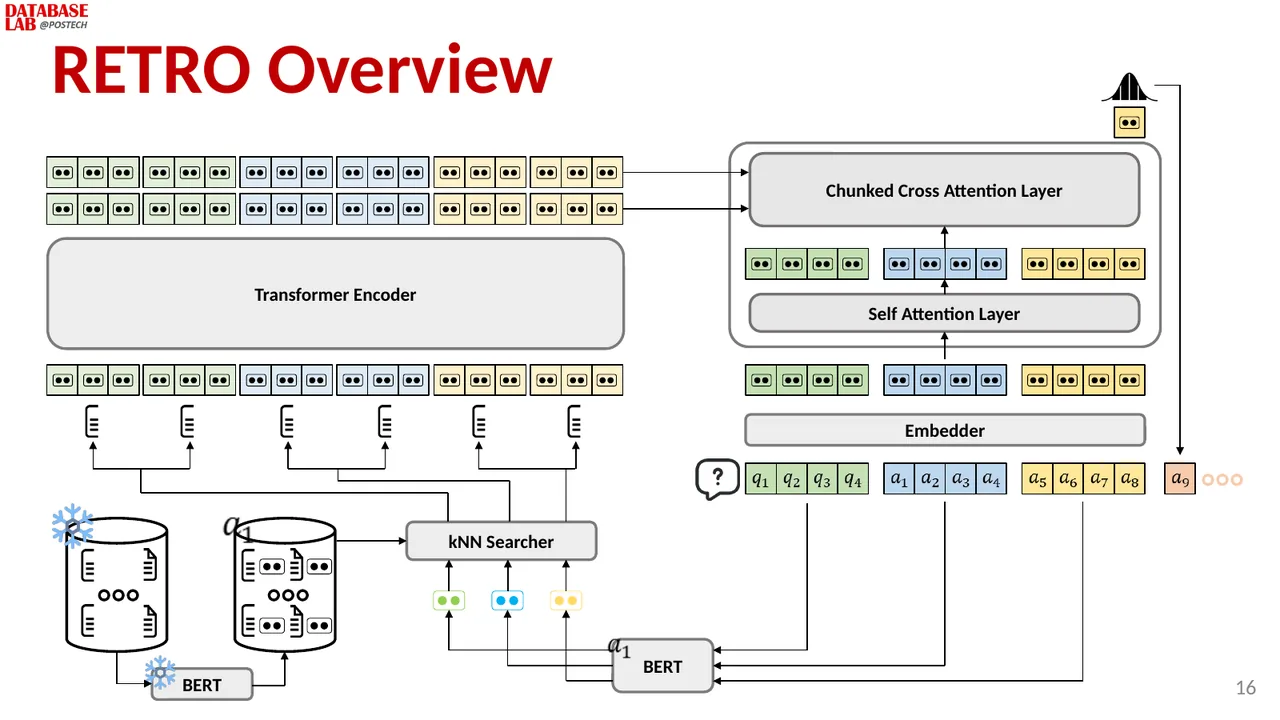
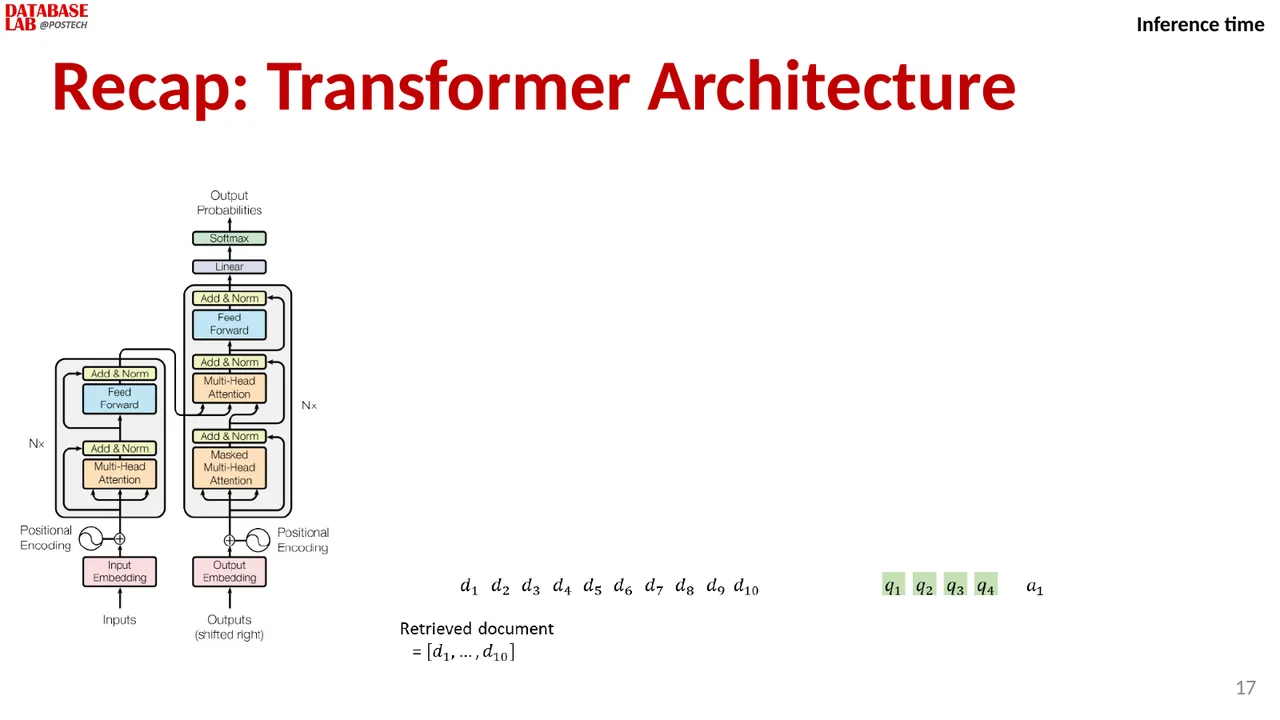
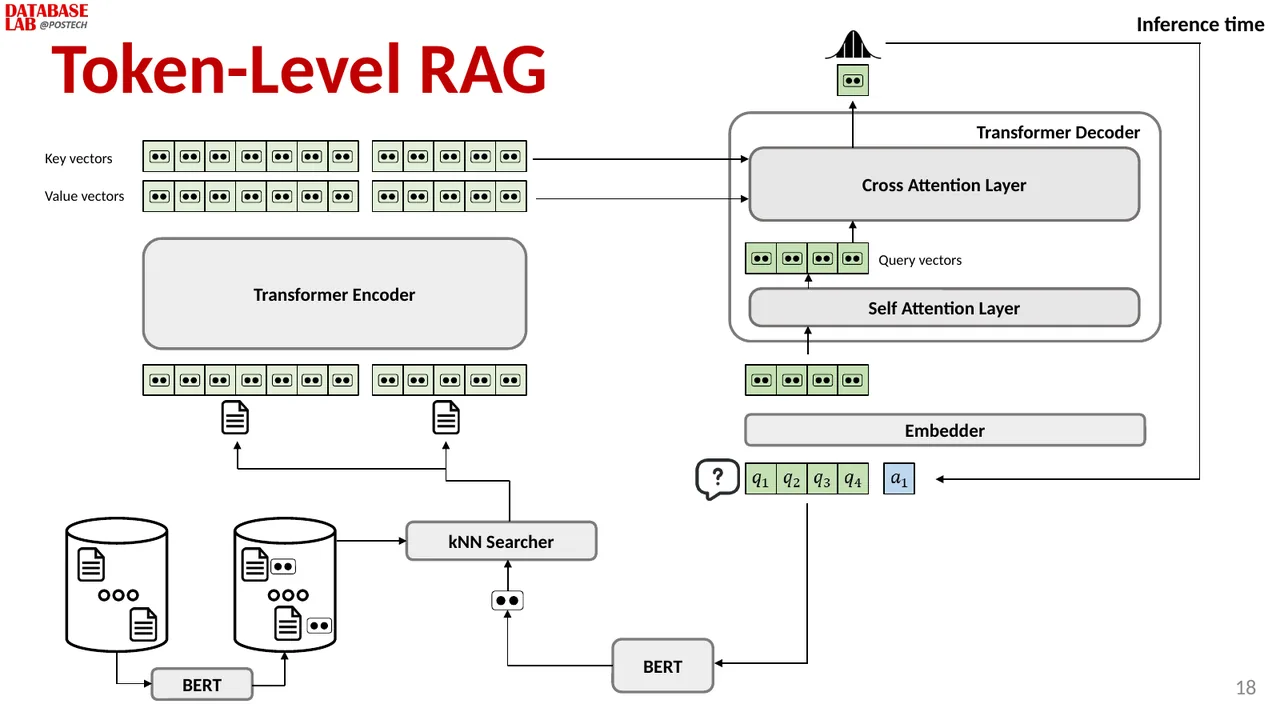
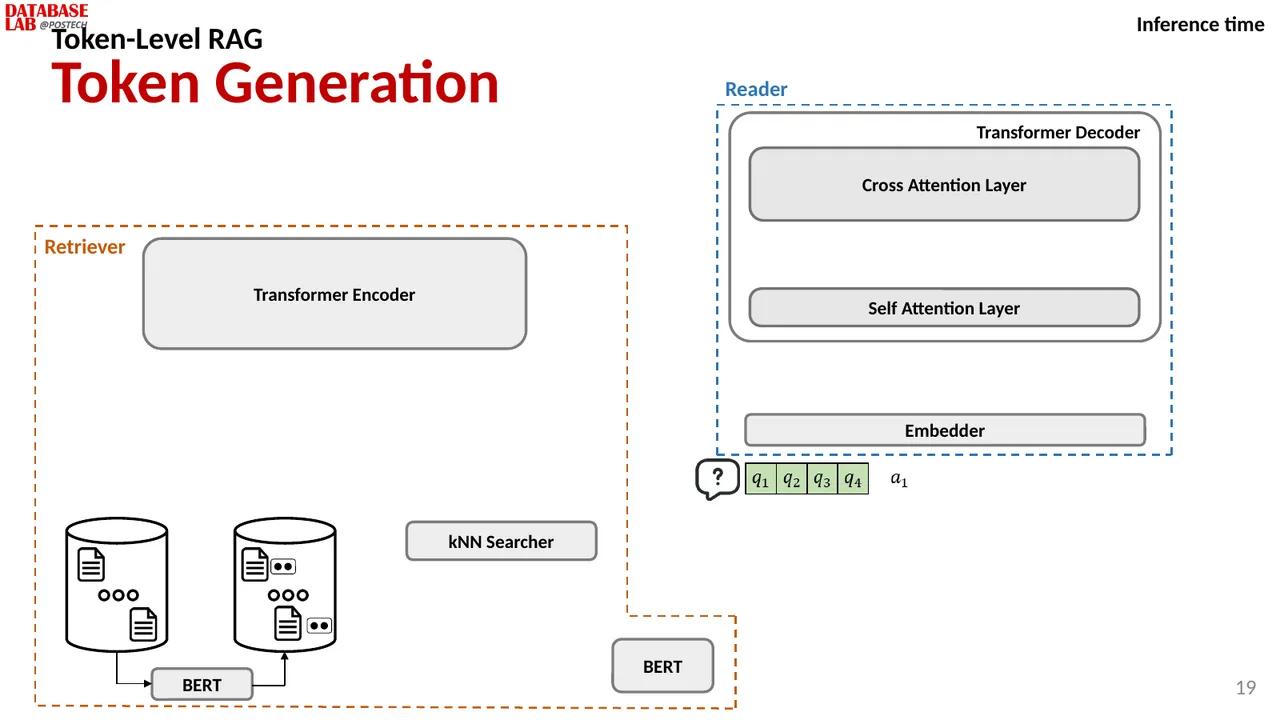
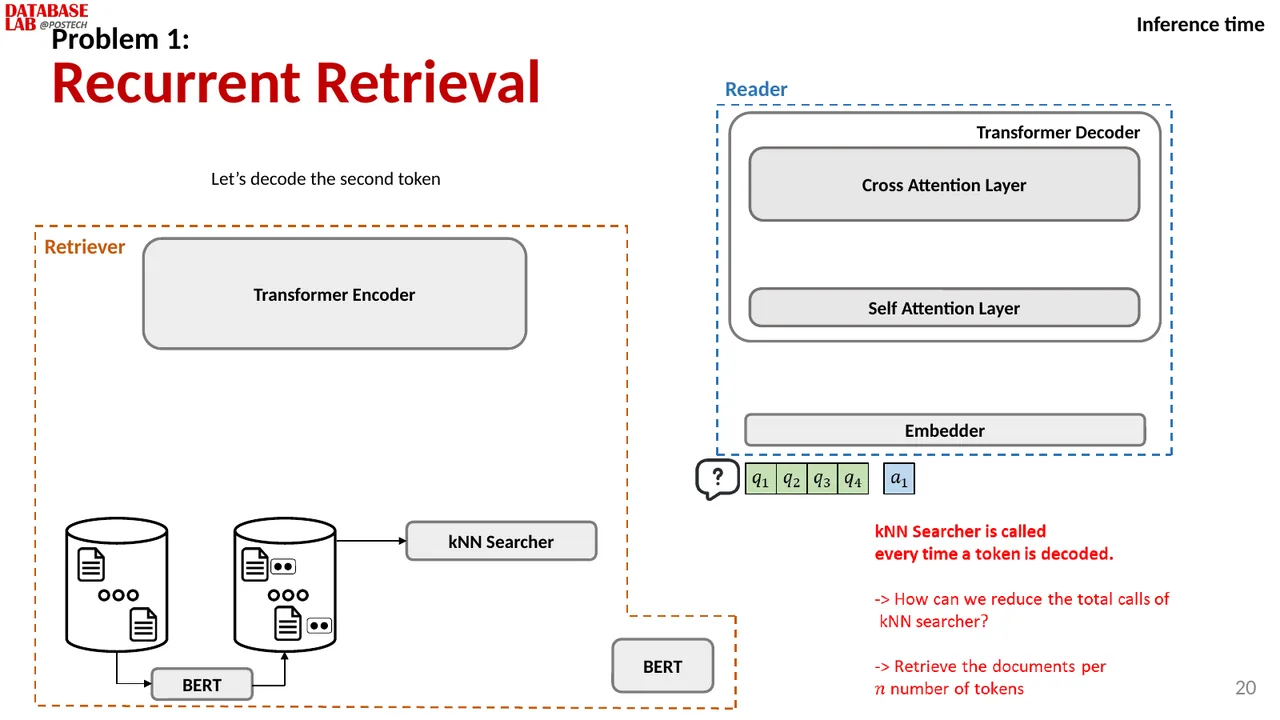
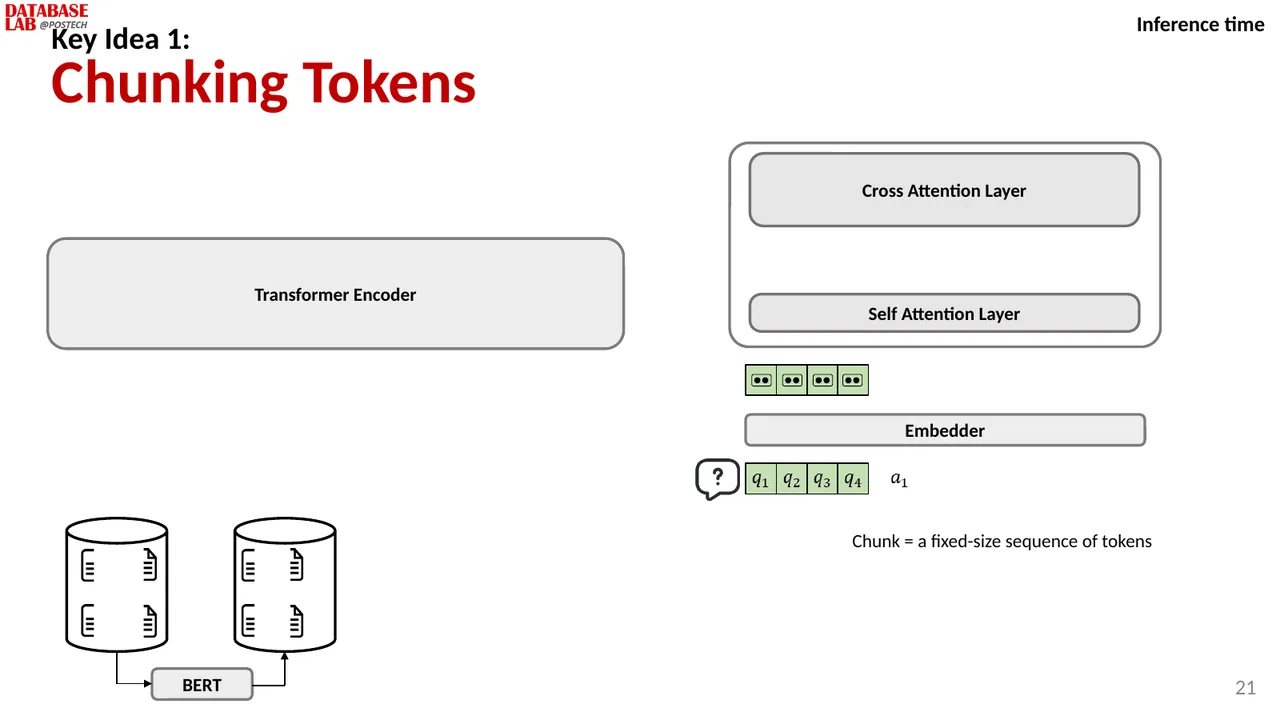
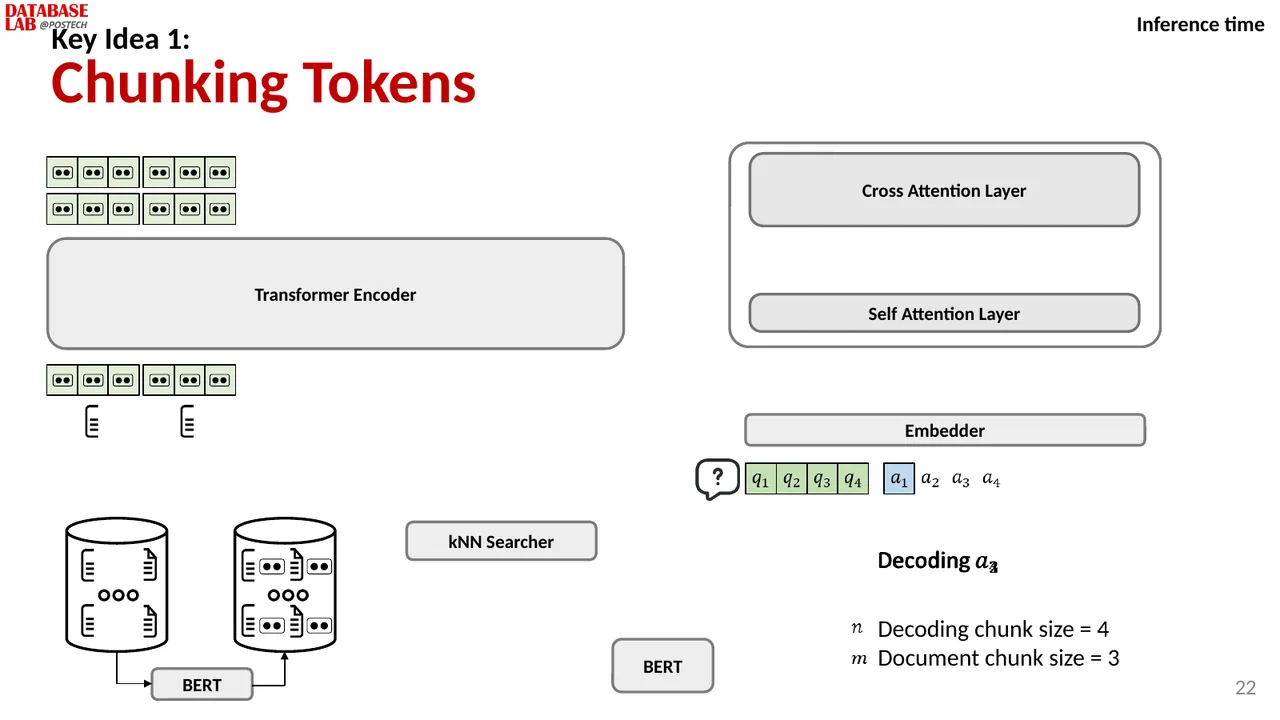
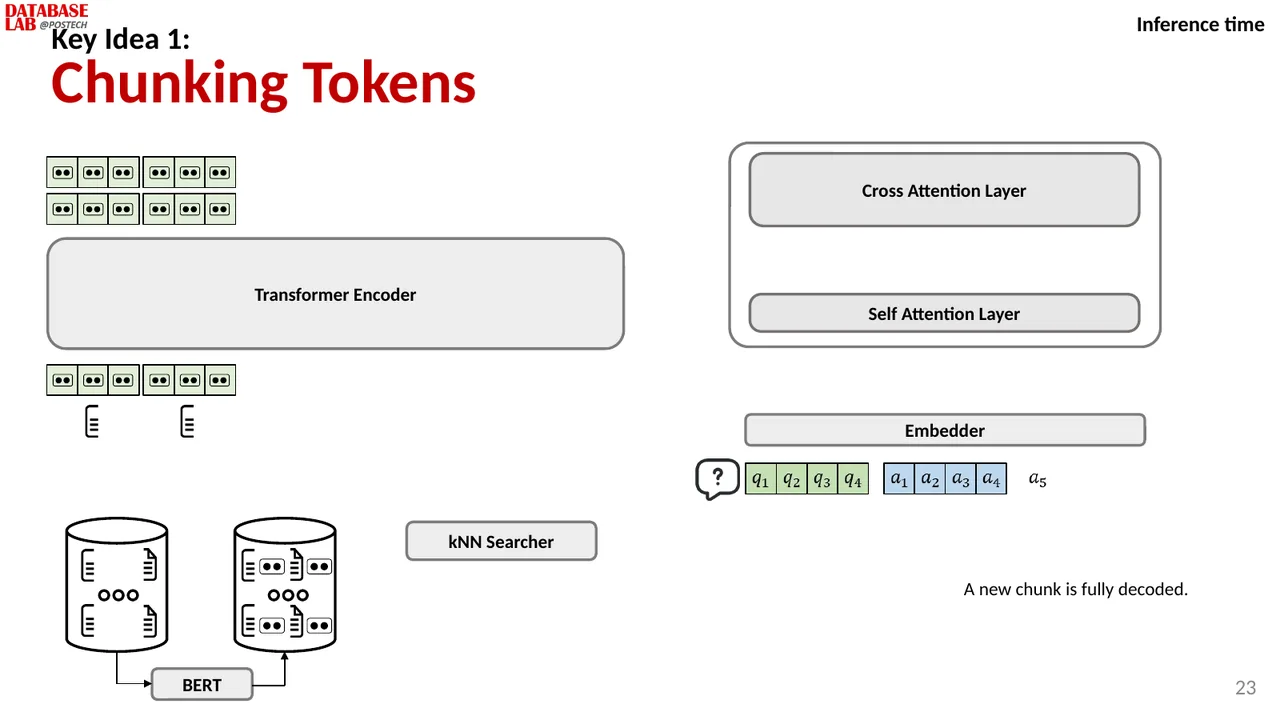
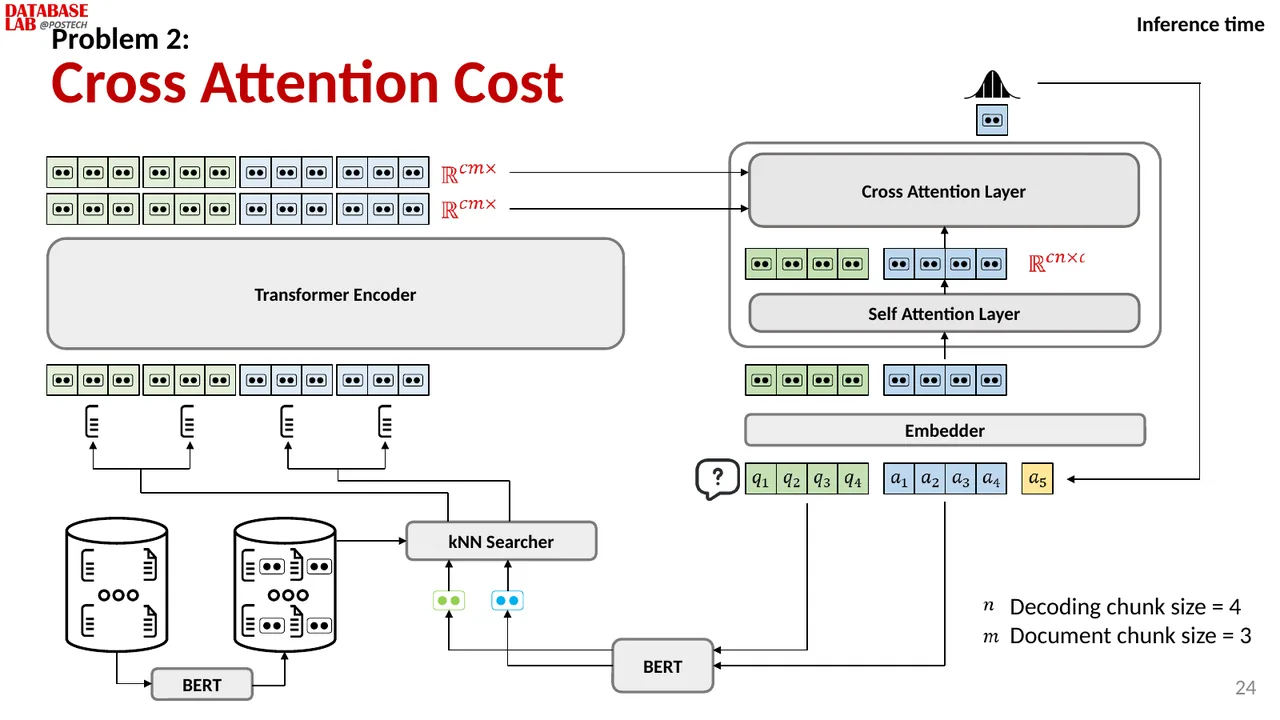
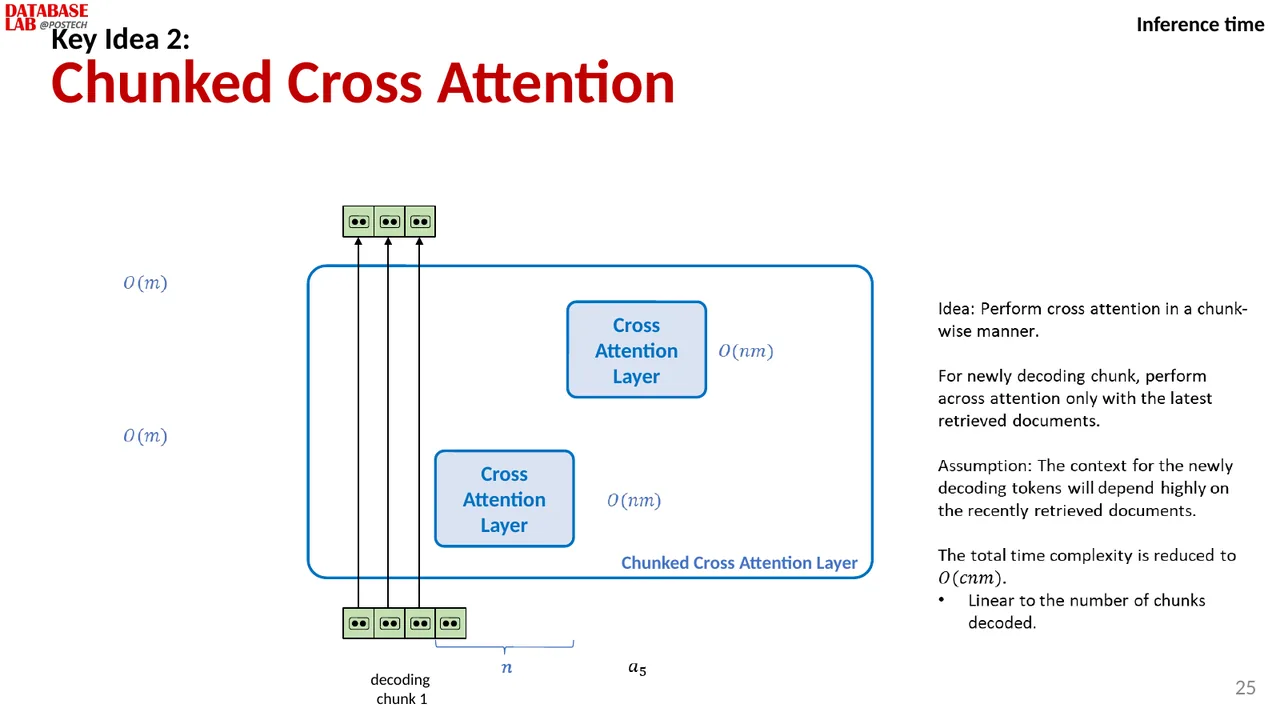
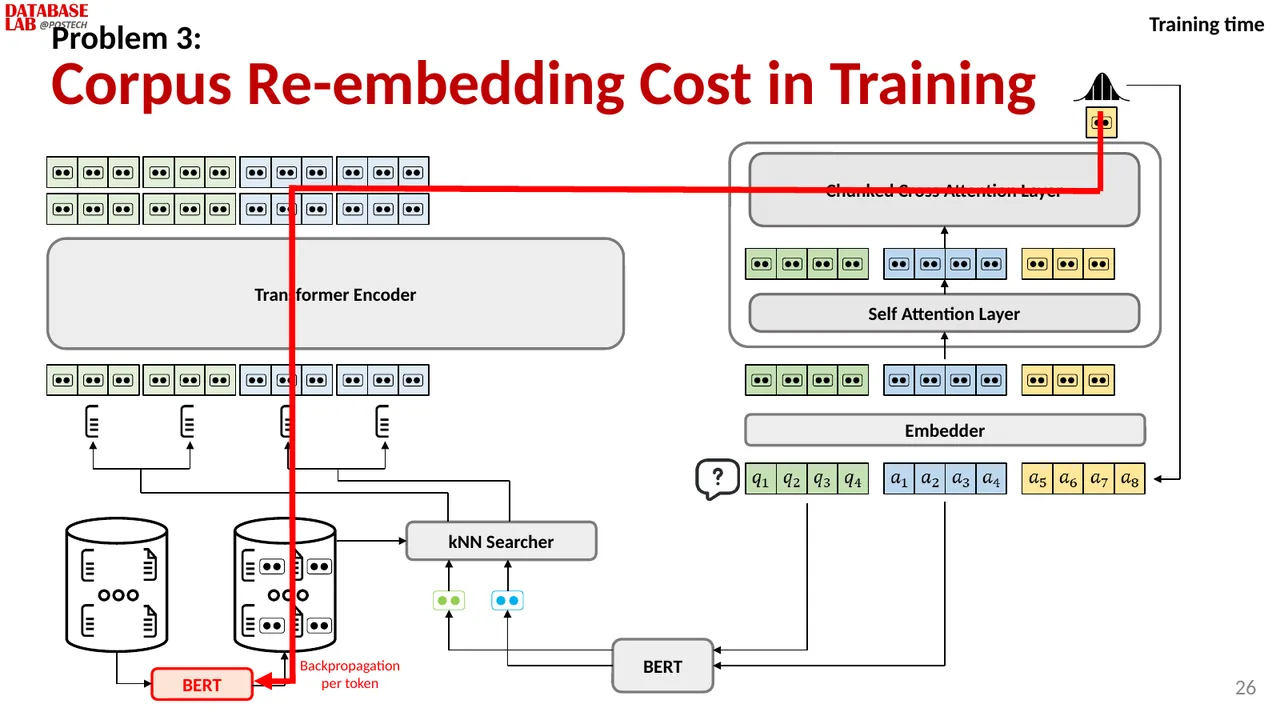
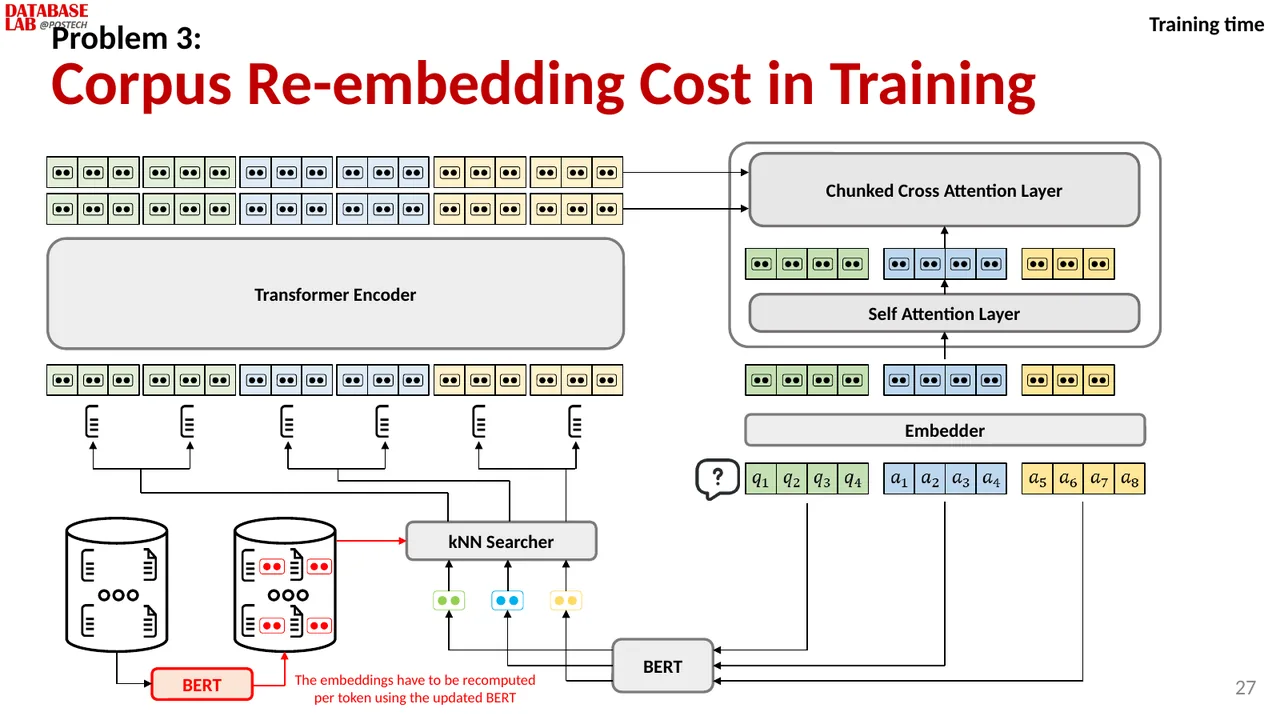
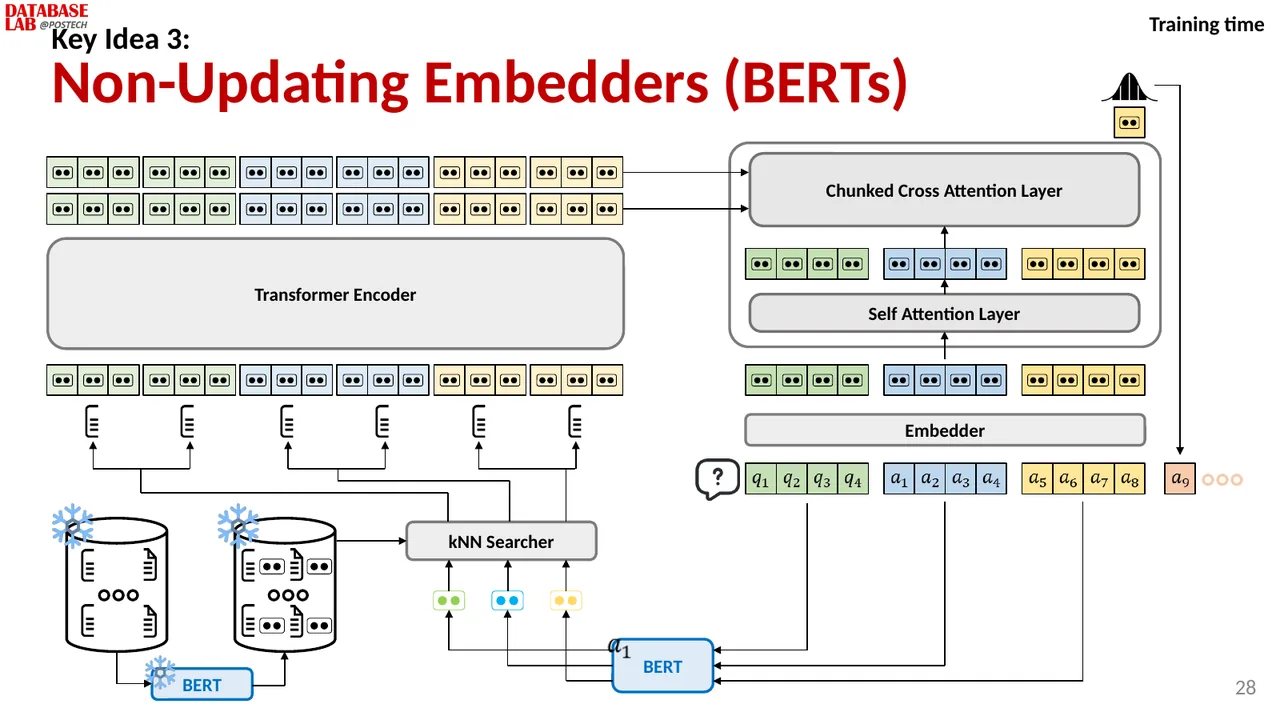
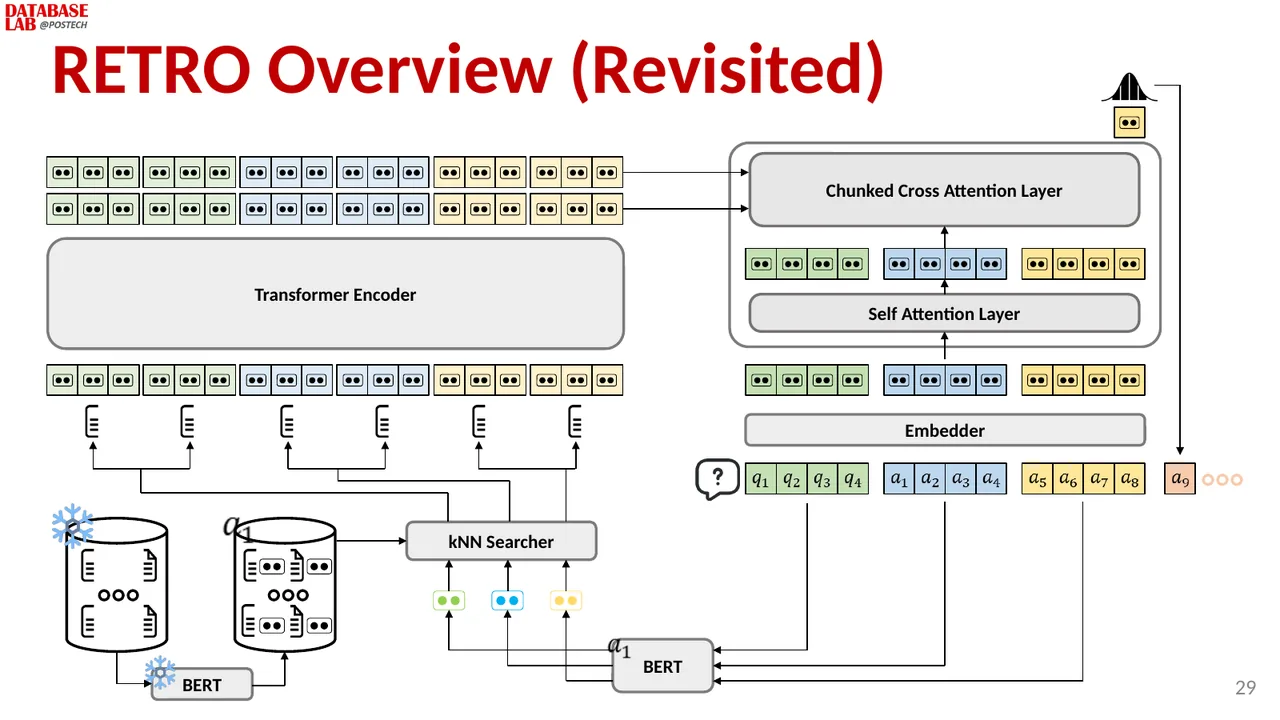
Token-level RAG built up on one diagram: why per-token retrieval is slow, then chunked retrieval, chunked cross-attention, and frozen BERT embedders, each introduced as the fix to a specific problem. Opens with a seven-slide recap of DiskANN.